

*Een schatting voor jezelf, een cijfer voor het MT en een cijfer voor de accountant zijn drie verschillende dingen. In je administratie weet je dat feilloos. In een AI-gesprek verdwijnt dat onderscheid, en niemand merkt het.*
Dinsdagochtend. Je vraagt je AI-assistent waarom de brutomarge op één klantgroep is weggezakt. Binnen een minuut ligt er een net antwoord: vier mogelijke oorzaken, een paar bedragen erbij, en een zin die je precies vertelt waar je moet gaan kijken. Zo was het ook bedoeld.
Dinsdagmiddag staat een van die bedragen in de toelichting bij de maandrapportage.
Er is niets misgegaan. Niemand heeft geknoeid en het bedrag klopt waarschijnlijk gewoon. Er is alleen nergens een moment geweest waarop iemand vaststelde: dit getal gaat nu van verkennen naar verantwoorden, en daar horen andere eisen bij.
Dat moment organiseren is de grootste winst die er dit jaar in je AI-inzet zit. Groter dan een beter model, een slimmere prompt of een extra tool.
Elk antwoord heeft een bestemming, en die bepaalt de lat
Als controller doe je dit onbewust al de hele dag. Een berekening op een kladblok om te zien of iets ongeveer klopt, behandel je anders dan een cijfer in de kolommenbalans. Je zou nooit een schatting rechtstreeks in een jaarrekening zetten. Het onderscheid zit niet in de rekensom, maar in wat er met de uitkomst gaat gebeuren.
In de praktijk gaan je antwoorden drie kanten op.
Ze blijven bij jou, omdat je aan het verkennen bent en wilt weten waar het uitzoekwerk zit. Ze gaan naar binnen, naar het MT of de DGA, waar iemand er een besluit op neemt. Of ze gaan naar buiten, naar de accountant, de bank, de aandeelhouder of de fiscus, waar je ze moet kunnen onderbouwen op een moment dat jij niet kiest.
Drie bestemmingen, drie totaal verschillende eisen. En één chatvenster waarin ze allemaal hetzelfde eruitzien.
Waarom dit bij AI misgaat en bij een spreadsheet niet
Een spreadsheet verraadt zijn eigen herkomst. Je klikt op een cel en je ziet of er een formule onder zit of dat iemand er een bedrag heeft ingetikt. Een hardgecodeerd getal tussen formules valt op. Dat is geen toeval, dat is jarenlang vakmanschap dat in de vorm is gaan zitten.
Een AI-antwoord heeft die gelaagdheid niet. Alles komt terug in dezelfde toon en met dezelfde stelligheid: het bedrag dat het model uit jouw bestand heeft gelezen, het bedrag dat het zelf heeft uitgerekend, en het bedrag dat het heeft ingevuld omdat de vraag erom vroeg en het patroon plausibel was. Er is geen visueel verschil tussen een cijfer dat aansluit en een cijfer dat er goed uitziet.
Dat is het echte risico. Niet dat het model fouten maakt, want die maken wij ook. Maar dat de uitvoer geen zekerheidsniveaus kent terwijl jouw werk dat wel doet.
Die twee lopen inmiddels aantoonbaar door elkaar. Uit de Workiva 2026 Midyear Executive Benchmark Survey onder ruim tweeduizend finance-, risk- en duurzaamheidsprofessionals blijkt dat een kwart van de Nederlandse deelnemers meldt dat interne audits AI-fouten ontdekten die externe partijen of de raad van bestuur al hadden bereikt. Uit hetzelfde onderzoek: 81 procent van de Nederlandse respondenten heeft enig tot veel vertrouwen in de nauwkeurigheid van AI-uitkomsten zonder menselijke controle, terwijl maar 14 procent de eigen datakwaliteit voldoende vindt voor AI-gebruik.
Lees die laatste twee nog eens naast elkaar. We vertrouwen de uitkomst ruimschoots meer dan de gegevens waar hij op gebaseerd is.
Drie bestemmingen, drie sets afspraken
De oplossing is niet strenger zijn tegen jezelf. Die houdt geen maand stand. De oplossing is het onderscheid in je inrichting zetten, zodat het niet van je discipline op vrijdagmiddag afhangt.
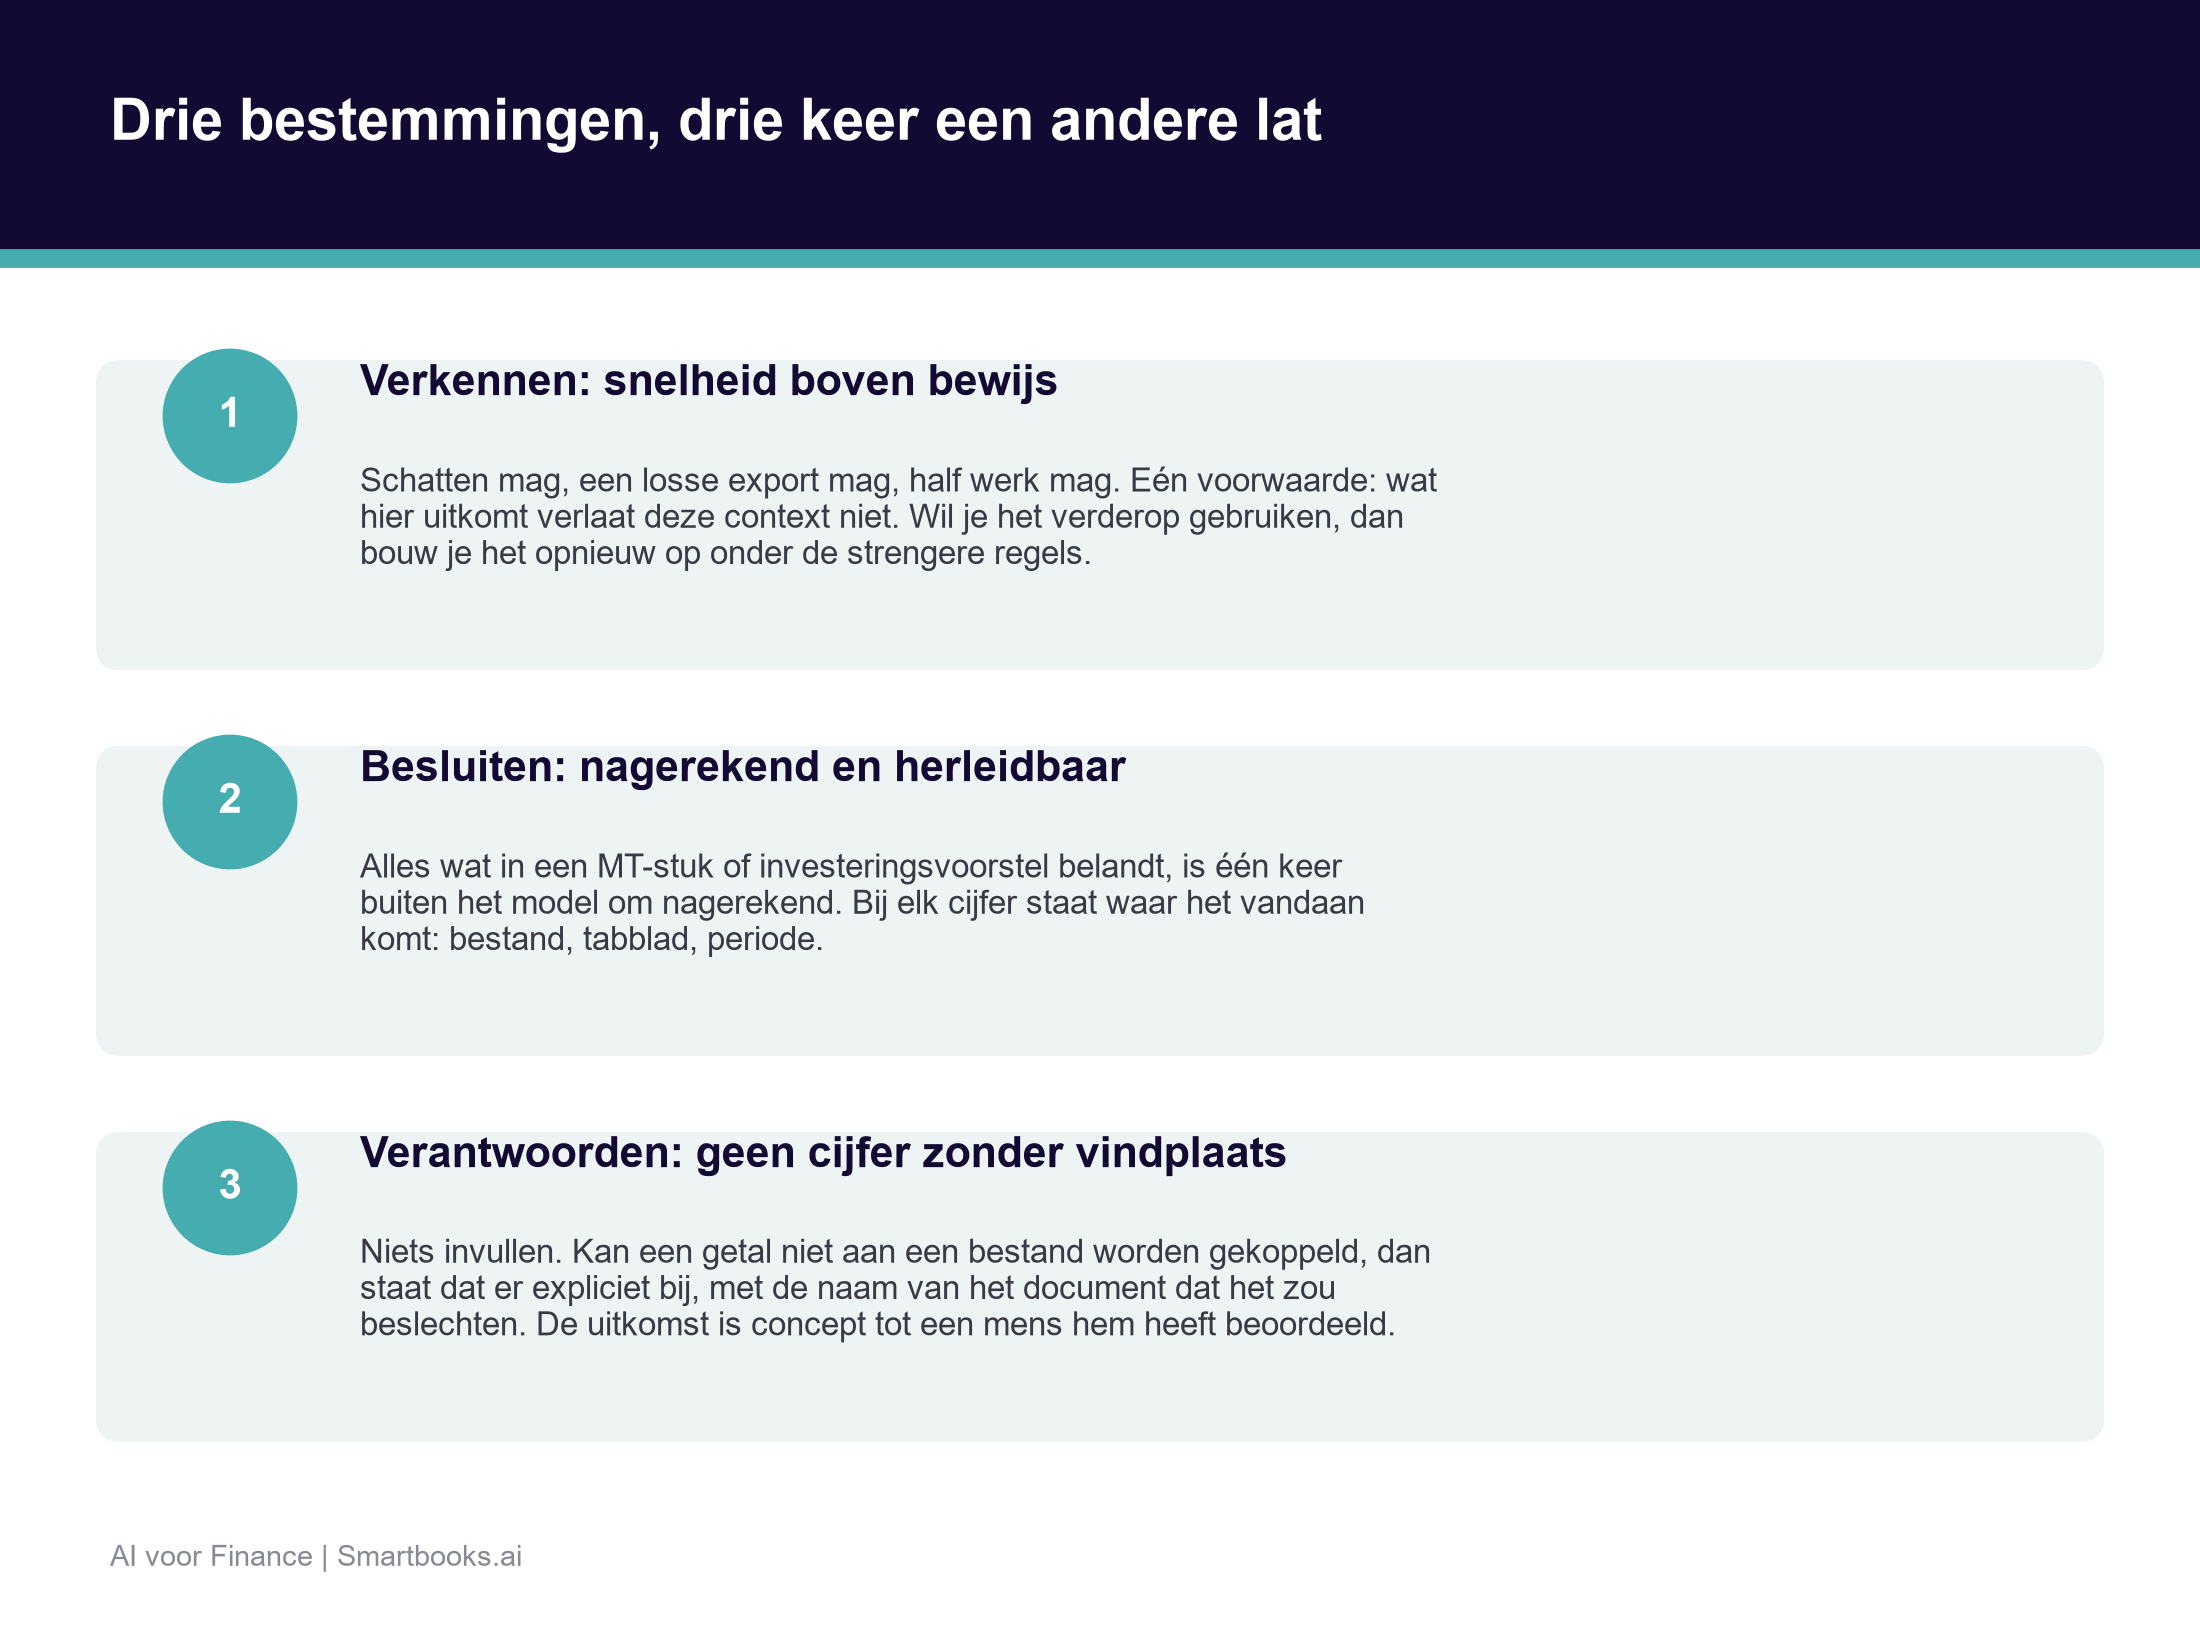
Verkennen. Snelheid gaat hier voor bewijs. Schatten mag, met een losse export werken mag, half werk mag. Eén voorwaarde, en die is absoluut: wat hier uitkomt verlaat deze context niet. Wil je een uitkomst verderop gebruiken, dan bouw je hem opnieuw op onder de regels hieronder. Kopiëren en plakken is precies de handeling die de hele scheiding onderuit haalt.
Besluiten. Alles wat in een MT-stuk of een investeringsvoorstel belandt, is één keer buiten het model om nagerekend, en bij elk cijfer staat waar het vandaan komt: bestand, tabblad, periode. Niet omdat het MT die bronvermelding leest, maar omdat jij hem over zes weken nodig hebt als iemand erop terugkomt.
Verantwoorden. Hier geldt de strengste regel, en die gaat niet over nauwkeurigheid maar over eerlijkheid: geen cijfer zonder vindplaats, en niets invullen. Kan iets niet aan een bestand gekoppeld worden, dan moet dat er als zodanig staan, met de naam van het document dat het zou beslechten. Alles wat hieruit komt is concept tot een mens het heeft beoordeeld.
Die laatste instructie is er één die zichzelf terugbetaalt, en het is de enige zin uit dit hele stuk die ik je zou aanraden letterlijk in je eigen AI-omgeving te zetten: *kun je een getal niet herleiden tot een bestand, meld dat dan expliciet en noem het bestand dat het zou beslechten.* Het foutscenario in finance is zelden een grof verkeerd bedrag. Het is een gaatje dat soepel is dichtgelopen.
Praktisch betekent dit ook dat je die drie soorten werk niet in dezelfde omgeving doet. Aparte werkruimtes, aparte bestandensets, aparte instructies. Je legt je losse exports en je verkennende vragen niet op dezelfde plek als de bestanden waarop je afsluit, om dezelfde reden dat je je klad niet in de definitieve map bewaart.
De eerlijke grens: scheiden regelt het gebruik, niet de bron
Twee dingen die hier tegenvallen, en die je van niemand hoort die AI verkoopt.
Het eerste: drie werkruimtes zijn drie keer onderhoud. Instructies verouderen, bestanden lopen uit elkaar, en de strenge omgeving raakt achterop omdat de losse omgeving nu eenmaal handiger werkt. Begin daarom met twee, verkennen en verantwoorden, en houd het besluitniveau voorlopig bij de strenge kant. Beter twee die je bijhoudt dan drie die verlopen.
Het tweede is fundamenteler. Dat cijfer over datakwaliteit hierboven gaat niet over AI, het gaat over de bron eronder. De strengste instructie ter wereld levert op een puntschatting uit een export van vorige dinsdag nog steeds een antwoord over vorige dinsdag op. Zolang de cijfers van vier BV’s in losse bestanden staan die elke maand opnieuw met de hand worden samengevoegd, betekent zo’n regel vooral dat het model vaker zegt dat het iets niet kan aansluiten. Dat is eerlijk en het is nuttig, maar het is geen oplossing. Eerst een betrouwbare, gestructureerde basis, dan AI daarbovenop. Andersom werkt niet.
Wat je accountant hier nu al van vindt
Dit is geen theoretisch punt meer. NBA Accounttech en NOREA publiceerden op 1 juni 2026 Leidraad 2: AI toegepast, met als kern dat AI voor hun leden nooit een black box mag zijn, omdat validatie en menselijk oordeel de basis moeten blijven van het publieke vertrouwen. Reproduceerbaarheid staat daar met zoveel woorden in.
Dat is hun beroepsregel en niet die van jou. Maar het is wel jouw dossier dat ze straks openslaan. Kun je niet reproduceren hoe een cijfer in de rapportage tot stand is gekomen, dan wordt dat een discussie tijdens de controle in plaats van ervoor. En een controle is de duurste plek om een vraag te beantwoorden die je in maart in twee minuten had kunnen vastleggen.
De bottom line
De vraag die iedereen stelt is hoe nauwkeurig AI is. Die vraag is niet fout, hij is alleen niet de eerste.
De eerste vraag is hoe ver het antwoord reist. Een uitkomst die bij jou op het scherm blijft, mag ruw zijn. Een uitkomst die de deur uit gaat, moet een spoor hebben. En het enige wat je hoeft te regelen is dat er een moment bestaat waarop het ene in het andere verandert, want dat moment ontbreekt nu bij vrijwel iedereen.
Een model dat af en toe zegt dat het iets niet kan aansluiten, is in dit vak meer waard dan een model dat altijd een antwoord heeft.
Bij Smartbooks bouwen we aan precies die onderlaag: één plek waar de cijfers van al je entiteiten samenkomen, zodat “waar komt dit vandaan” een verwijzing is en geen zoektocht. De rest is inrichting, en die kun je maandag beginnen.
Tot volgende week,
Jaap