

*De vraag is bijna nooit of het model je cijfers veilig bewaart. De vraag is hoeveel kopieën van die cijfers er inmiddels rondslingeren, en of iemand nog weet waar.*
Het komt meestal van de accountant of van de DGA, ergens tussen twee agendapunten door: we gaan onze cijfers toch niet in zo’n AI stoppen? Je zegt nee, iedereen knikt, en daarmee geldt het onderwerp als afgehandeld.
Kijk daarna eens in je eigen mailbox. Daar staat de geconsolideerde marge per vestiging als bijlage bij een mail aan de accountant. In je downloadmap staan drie versies van dezelfde kolommenbalans, want de tweede klopte niet en de derde is de goede. De bank kreeg vorig kwartaal een liquiditeitsprognose voor de financieringsaanvraag. Op de telefoon van de DGA staat een screenshot van de omzetgrafiek, doorgestuurd in een appje omdat hij onderweg was naar een gesprek. En ergens staat een werkmap met een tabblad waarin de personeelskosten per kostenplaats staan, bij een afdeling van vier man, dus in de praktijk herleidbaar tot een persoon.
Dat is geen slordigheid. Dat is hoe finance werkt.
Waar Nederlandse datalekken werkelijk vandaan komen
De aanname onder die vergadering is dat een datalek iets is dat je overkomt: een aanval, een inbraak, een gestolen laptop. De cijfers zeggen iets anders. Bij de Autoriteit Persoonsgegevens werden in 2025 in totaal 39.407 datalekken gemeld. In 25.189 van die meldingen ging het om een brief, meestal een die bij de verkeerde ontvanger belandde. Cyberaanvallen waren goed voor 2.428 meldingen, en een verloren of gestolen apparaat, USB-stick of stapel papier voor 419.
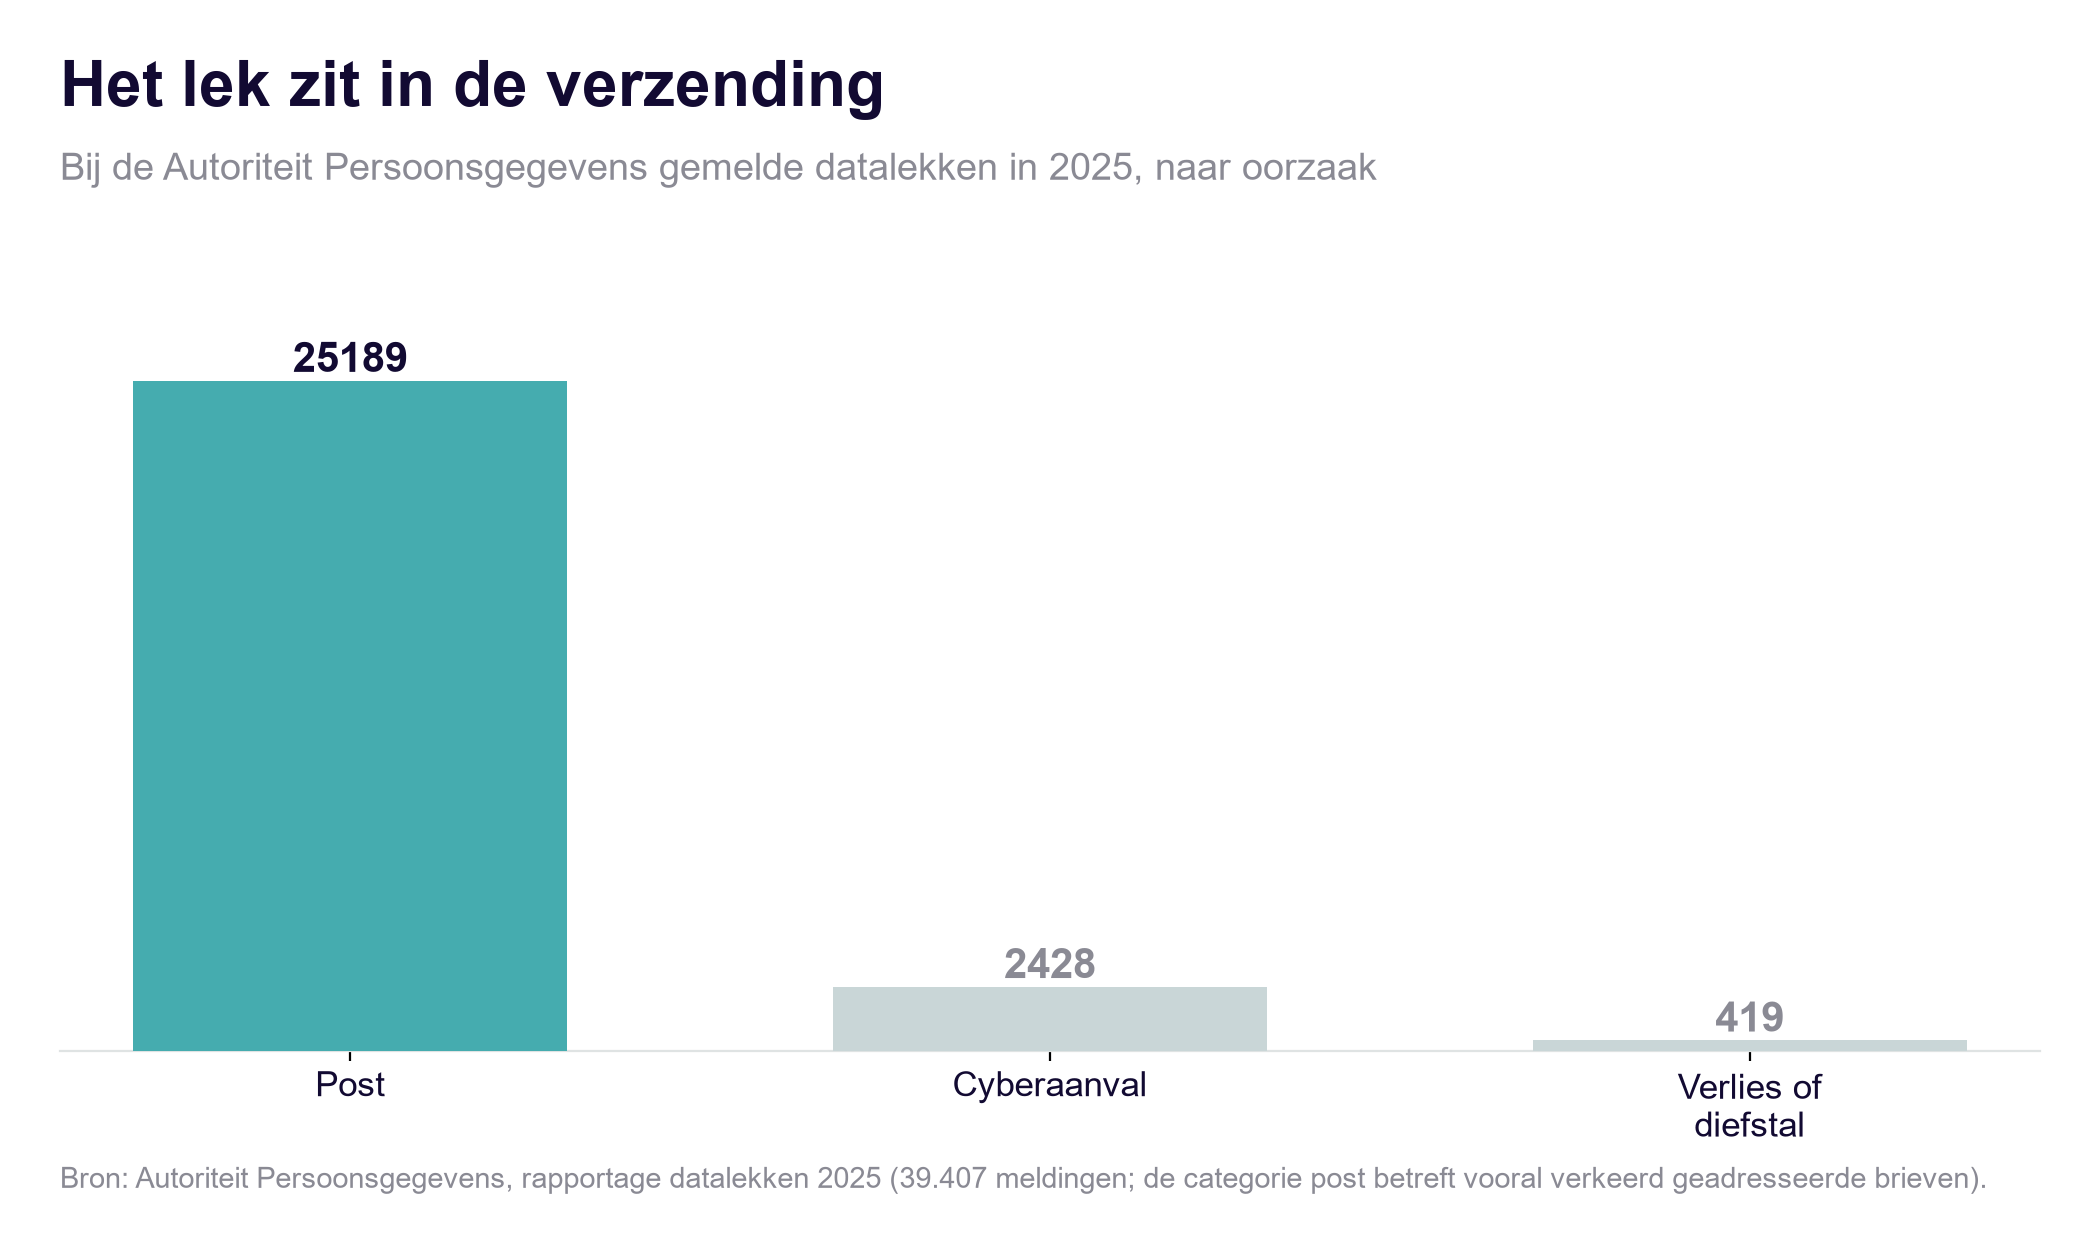
Lees die verhouding nog even terug. Ruim zes van de tien gemelde lekken gaan over iets wat verstuurd is en daarna bij de verkeerde terechtkwam, terwijl de klassieke aanval en het kwijtgeraakte apparaat samen een fractie van het totaal vormen. Het lek zit vrijwel nooit in het slot. Het zit in de verzending.
Waarom finance hier gevoeliger voor is dan de rest van het bedrijf
Bij de meeste afdelingen is een export een uitzondering. Bij ons is het het werkproces. Je trekt per BV een kolommenbalans uit Exact of Twinfield, want een kant-en-klare geconsolideerde P&L komt daar niet uit, en de rest bouw je zelf. Dat betekent per definitie een bestand, en zodra er een bestand is, is er een kopie, en zodra er een kopie is gaat die naar iemand toe.
Daar komt bij dat de inhoud van die bestanden zwaarder weegt dan gemiddeld. Cijfers van de lopende maand voordat ze definitief zijn. Een scenario waarin twee vestigingen worden samengevoegd, met functies erbij. Loonkosten die bij een klein team direct naar een persoon te herleiden zijn, waarmee je volgens de AVG met persoonsgegevens werkt en niet met een saldo. De toelichting die je voor de bank schreef en daarna op verzoek iets vriendelijker formuleerde.
Van geen van die bestanden kun je op dit moment zeggen waar ze allemaal staan en wie er nog een kopie van heeft. Dat was al zo voordat er iemand over AI begon.
Wat AI hieraan toevoegt is geen nieuw risico. Het is tempo. Een export in een chatvenster plakken is dezelfde handeling als een export naar de accountant mailen, alleen doe je hem vaker omdat het antwoord bruikbaar is. Het probleem dat je daarmee vergroot is het probleem dat je al had.
Drie vragen die wel iets opleveren
Zolang de discussie gaat over de vraag of het model te vertrouwen is, praat je over de opslag terwijl je probleem de verspreiding is. Deze drie vragen zitten wel op het goede niveau, en ze gaan geen van drieën over AI.
Wie mag welk cijfer zien, en is dat afgedwongen of afgesproken? Bij de meeste MKB-groepen is het antwoord: afgesproken. Iedereen die bij het bestand kan, ziet alles wat erin staat, want een werkmap kent geen rechten per tabblad. Dat betekent dat de stagiair die de aging bijwerkt technisch gezien ook bij het directiesalaris kan. Een afspraak is geen maatregel, en je accountant zal je dat vroeg of laat ook vertellen.
Kun je van een cijfer terugvinden waar het vandaan komt? Niet welk model je hebt gebruikt, maar welke administratie, welke periode en welke correctie. Dit is de vraag die je bij de jaarrekening krijgt, en het is ook de enige echte controle op een AI-antwoord. Kun je het niet terugvinden, dan kun je het ook niet weerleggen.
Wat blijft er staan als het gesprek klaar is? Bij een export is het antwoord altijd: een bestand, ergens. Bij een koppeling die leest uit een systeem is het antwoord: niets, want er is nooit een kopie gemaakt. Dat verschil is groter dan alle instellingen in je AI-tool bij elkaar.
Wat je deze week alsnog kunt regelen
Er is een laag hygiëne die niets kost en die je gewoon moet doen, ook al lost hij het bovenstaande niet op.
Werk met een zakelijk account en niet met een privé-account waarop toevallig bedrijfscijfers voorbijkomen. Dat onderscheid is bij Anthropic geen detail: bij consumentenaccounts geldt dat je gegevens tot vijf jaar in de trainingspijplijn bewaard kunnen blijven als je toestemming voor modelverbetering aan hebt staan, terwijl zakelijke overeenkomsten voor Team en Enterprise buiten training vallen. Loop daarnaast één keer je geheugen- en historie-instellingen langs, zodat je weet wat er tussen gesprekken door wordt onthouden.
Dat kost een half uur en het is verstandig. Maar wees eerlijk over wat het is: je hebt daarmee het chatvenster netjes gezet, terwijl je cijfers nog steeds in vijftien bestanden staan waarvan er drie de goede zijn.
De eerlijke grens: toegang is geen kwaliteit
Hier hoort een waarschuwing bij, want er is een prettige denkfout die precies op dit punt insluipt. Zodra je AI rechtstreeks op je administratie laat kijken in plaats van op een export, voelt het antwoord betrouwbaarder. Dat is het maar half.
Een model met leesrechten op je grootboek kan nog steeds een plausibel en fout cijfer geven. Het kan een rekening meenemen die jullie in de ene BV anders gebruiken dan in de andere, of intercompany laten staan waar het eruit moest. Rechten regelen wie iets mag zien. Ze zeggen niets over of het klopt. De controle op de uitkomst blijft van jou, en dat blijft zo.
Bovendien erft een koppeling het rechtenmodel dat je al hebt. Staat in jullie administratie iedereen ingericht als “mag alles zien”, dan is het enige wat je hebt bereikt dat iedereen dat nu ook sneller kan. Wie de toegangsvraag nooit heeft beantwoord, beantwoordt hem niet door er een koppeling overheen te leggen.
En dan de valkuil waar het meestal echt op misgaat: een verbod werkt niet. Zeg je in de MT-vergadering nee, dan verdwijnt het gebruik niet, maar wel je zicht erop. Het gebeurt dan thuis, op een privé-account, met een export die niemand heeft geregistreerd. Dat is precies het scenario dat je in die vergadering dacht af te wenden.
De bottom line
Veiligheid is in finance geen instelling die je aanzet. Het is een gevolg van waar je cijfers staan, en dat is een inrichtingskeuze die je jaren geleden hebt gemaakt zonder er zo over na te denken.
De vraag is dus niet of je AI bij je cijfers laat. De vraag is of je cijfers ergens staan waar dat überhaupt een beheersbare vraag is. Zolang het antwoord vijftien werkmappen is, is elk antwoord op de eerste vraag een aanname.
Dat wij bij Smartbooks aan die ene plek werken, waar rapportage, planning en consolidatie over al je entiteiten samenkomen, zal je niet verbazen. Maar de inventarisatie waar dit stuk mee begon kun je vanmiddag zelf doen, zonder iets aan te schaffen: zoek in je mailbox op de bestandsnaam van je laatste rapportage en tel de resultaten.
Ik ben benieuwd op welk getal je uitkomt. Bij de meeste mensen is het er één te veel.
Tot de volgende,
Jaap