

*Je beoordeelt software in een uur, en in dat uur zie je vooral het scherm. Precies het deel dat sinds kort niets meer bewijst.*
Je zit in een demo van een rapportagepakket. De leverancier deelt zijn scherm, er verschijnt een geconsolideerde P&L met marge per vestiging, een paar filters, een grafiek die netjes meebeweegt. Het ziet er goed uit. En je beoordeelt wat je ziet, want in dat ene uur is dat het enige wat er te beoordelen valt.
Ik zit zelf elke week in dat soort gesprekken, aan de andere kant van het scherm. De vragen die ik krijg gaan bijna allemaal over wat er te zien is. Kan die kolom ergens anders staan. Kan dit ook per kostenplaats. Krijg ik dit in een presentatie.
Dat zijn redelijke vragen. Ze waren tot voor kort ook de belangrijkste vragen. Dat zijn ze niet meer, en dat is een vervelender bericht dan het lijkt, want het criterium waarmee de meeste finance-teams software kiezen is stilletjes waardeloos geworden.
Waarom het scherm zo lang een goede maatstaf was
Twintig jaar lang was een rapport bouwen duur. Iemand moest je administraties ontsluiten, je rekeningschema’s op elkaar leggen, de intercompany eruit halen en dat allemaal ergens neerzetten waar het herhaalbaar bleef. Pas daarna kon er een scherm bovenop.
Dat maakte het zichtbare deel een prima afgeleide van het onzichtbare deel. Een leverancier die je een kloppende geconsolideerde P&L liet zien, had die alleen kunnen tonen door eerst het saaie werk eronder te doen. Je beoordeelde het scherm en kocht impliciet de fundering mee. Dat werkte, en niemand hoefde er lang over na te denken.
Die koppeling is doorgeknipt.
Een model met toegang tot je cijfers zet binnen een paar minuten een overzicht neer dat het in een demo uitstekend doet. Grafiek erbij, kleuren kloppen, totalen tellen op. Wat vroeger een implementatietraject was, is nu een middagje. Het scherm is van schaars naar bijna gratis gegaan, en daarmee is het gestopt iets te bewijzen over wat eronder ligt.
Wat níét gratis is geworden: dat het cijfer op dat scherm er volgende maand nog net zo staat, dat je kunt navertellen waar het vandaan komt, en dat de definitie erachter dezelfde is als die van je collega in een andere BV.
Het bewijs zit in wat je kunt aantonen, niet in wat je kunt tonen
KPMG ondervroeg dit voorjaar ruim duizend finance-leiders en vond een scherp verschil. Organisaties die audit-bewijs kunnen produceren en uitleggen, melden drie tot zes keer vaker verbetering in foutreductie dan hun collega’s, 33 procent tegenover 6 procent, en hebben meer vertrouwen in het opschalen van AI, 42 procent tegenover 14 procent. Het onderscheid dat het meeste verklaart, is dus niet welk model je gebruikt. Het is of je kunt laten zien hoe je aan de uitkomst bent gekomen.
Dat rijmt met wat CFO’s zelf als rem noemen. EY sprak dit voorjaar ruim vijftienhonderd finance-leiders en zag dat datakwaliteit met 61 procent bovenaan staat bij het rondkrijgen van AI-investeringen, terwijl slechts 21 procent de eigen finance-functie leidend of vergevorderd noemt.
De aandacht gaat naar het model. De rem zit een laag lager.
De vragen die in een demo wél iets onderscheiden
Het goede nieuws is dat je die onderlaag kunt toetsen, ook in een uur, ook zonder technische achtergrond. Je moet alleen andere vragen stellen dan de vragen die vanzelf opkomen.
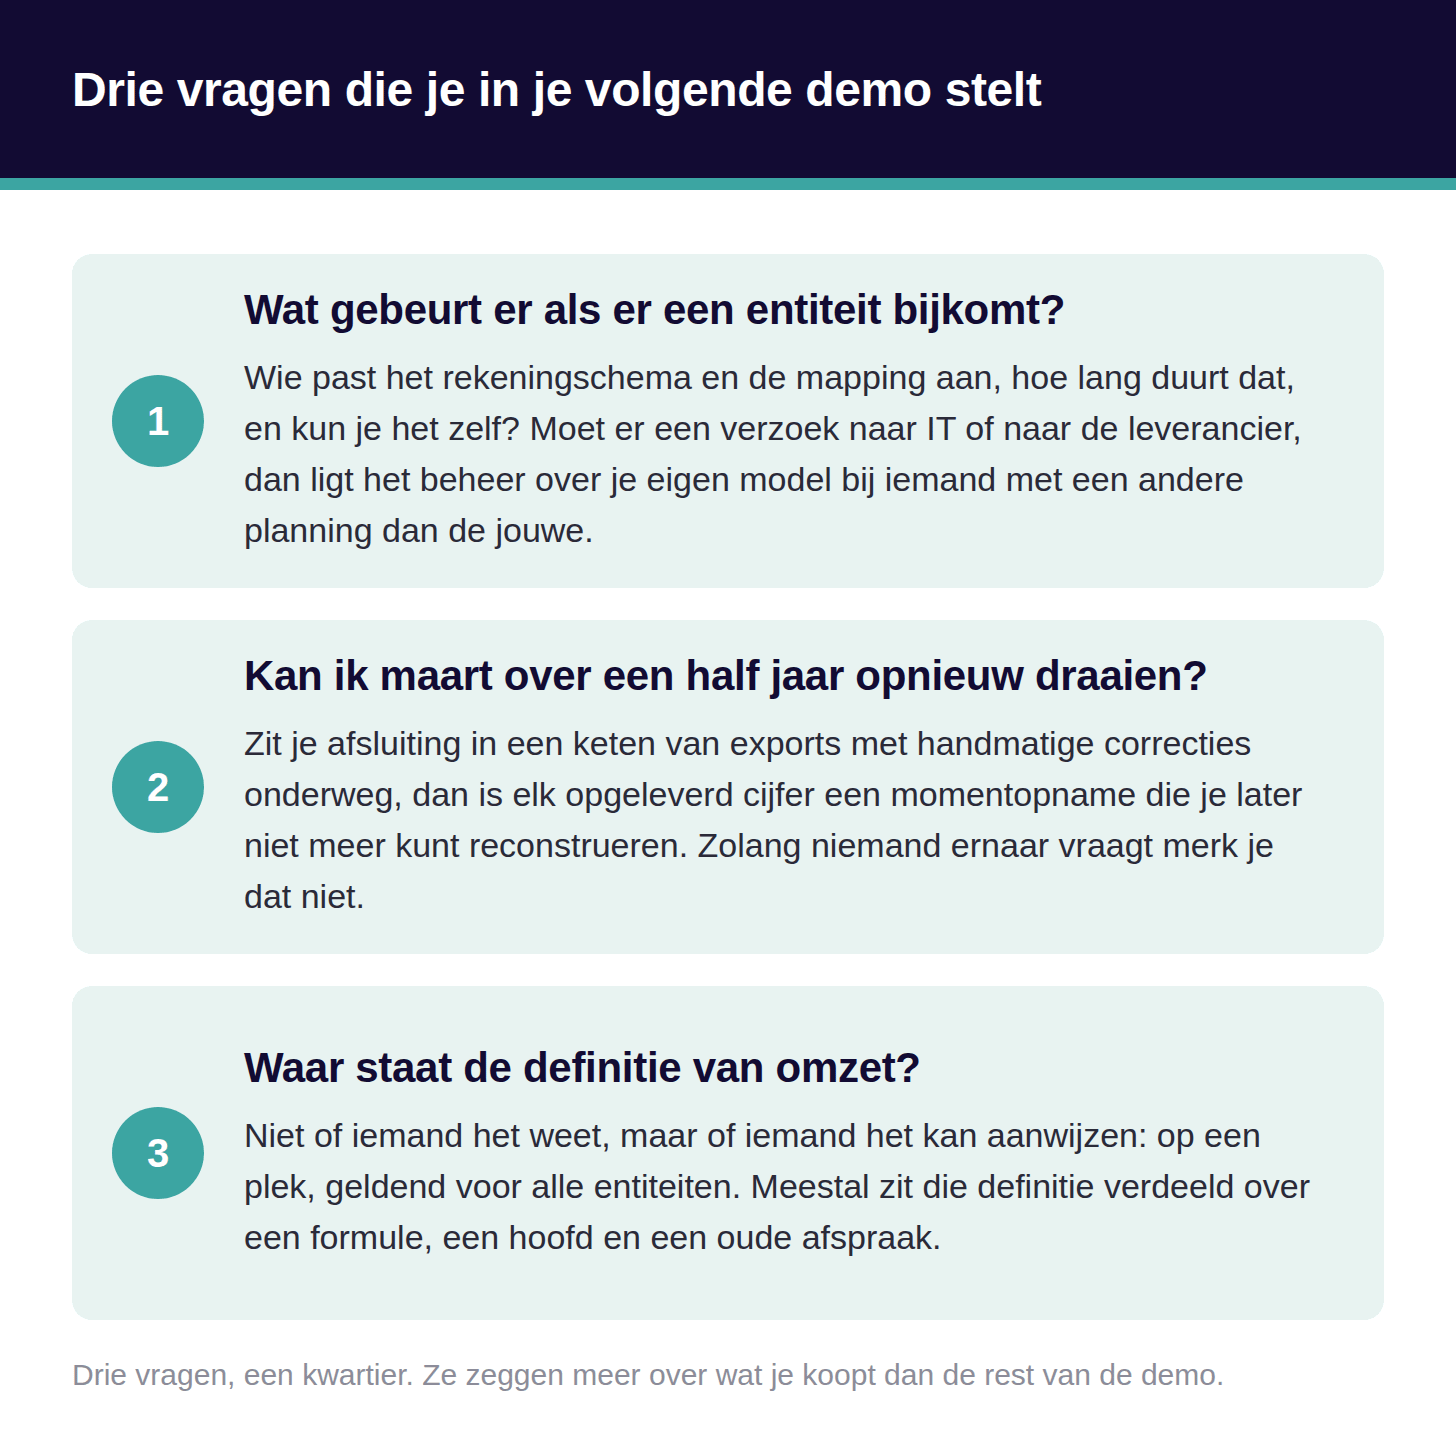
Wat gebeurt er als er een entiteit bijkomt? Vraag wie het rekeningschema en de mapping aanpast, hoe lang dat duurt en of jij dat zelf kunt. In een MKB-groep verandert die structuur vaker dan je zou willen: een overname, een activiteit die naar een eigen BV gaat, een kostenplaats die wordt gesplitst. Is het antwoord dat er een verzoek bij de IT-afdeling of de leverancier moet, dan heb je het beheer over je eigen model weggegeven aan iemand met een andere planning dan de jouwe.
Kan ik de rapportage van maart over een half jaar opnieuw draaien en krijg ik hetzelfde? Dit is de vraag die het meeste blootlegt. Zit je afsluiting in een keten van exports met handmatige correcties onderweg, dan is het antwoord nee, en is elk cijfer dat je oplevert een momentopname die je later niet meer kunt reconstrueren. Zolang niemand ernaar vraagt merk je dat niet. Je accountant vraagt er wel naar.
Waar staat de definitie van omzet, en kun je hem aanwijzen? Niet: weet iemand het. Kan iemand het aanwijzen, op één plek, geldend voor alle entiteiten. In de meeste groepen zit die definitie verdeeld over een formule in een tabblad, het hoofd van de controller en een afspraak van jaren geleden die niemand meer kan navertellen. Dat gaat prima zolang mensen de vertaalslag maken. Zodra een model het overneemt, verdwijnt precies die vertaalslag.
Drie vragen, een kwartier. Ze zeggen meer over wat je koopt dan de rest van de demo bij elkaar.
De eerlijke grens: een fundering maakt niets waar
Nu de nuance, en die is belangrijk genoeg om er een sectie aan te geven.
Een goede onderlaag maakt een taalmodel niet betrouwbaar. Een model voorspelt een antwoord in plaats van het uit te rekenen, en het blijft in staat om met volle overtuiging iets te zeggen dat net niet klopt. Dat verandert niet door je administratie op orde te brengen.
Wat wel verandert, is bescheidener en nuttiger: het antwoord wordt controleerbaar. Je kunt terug naar de bron, je kunt het opnieuw draaien, je kunt zien welke definitie is gebruikt. Fout blijven mogelijk, maar onopgemerkt fout wordt een stuk moeilijker. In ons vak is dat het hele verschil, want een verkeerd cijfer dat je vindt kost een uur en een verkeerd cijfer dat je niet vindt kost je geloofwaardigheid.
Wees ook eerlijk over het bewijs hierboven. Die onderzoeken gaan over grote organisaties, met steekproeven die beginnen bij bedrijven van een kwart miljard omzet. Jouw groep is dat niet. Ik denk dat het mechanisme hetzelfde werkt en de marge kleiner is, want jij hebt geen tweede team dat een fout eruit haalt voordat hij naar buiten gaat.
En let op het woord zelf. Fundering, basis, de laag eronder: dat gaat binnenkort iedere leverancier zeggen, en dan zegt het niets meer. Het woord is geen selectiecriterium. De drie vragen wel.
De bottom line
Het mooiste rapport in de zaal zegt sinds kort niets meer over de administratie eronder. Dat is precies andersom dan het twintig jaar was, en de meeste selectietrajecten die ik zie lopen nog op het oude criterium.
De leveranciers zijn daar overigens eerder achter dan hun klanten. Wouter Born sprak onlangs de CEO van een FP&A-leverancier die zijn eigen betalende klanten adviseerde hun dashboards voortaan zelf met een AI-model te bouwen, en die zijn bedrijf opnieuw inrichtte rond de gegevenslaag eronder. Een softwaremaker die publiekelijk zijn eigen schermen overbodig verklaart, is een steviger signaal dan welk onderzoek ook.
Dat wij bij Smartbooks aan die onderkant werken, aan één plek waar de cijfers en de definities van al je entiteiten elke maand op dezelfde manier samenkomen, zal je niet verbazen. Maar je hebt ons niet nodig om die drie vragen te stellen. Stel ze bij de volgende demo die je krijgt, ook als die van ons is.
Welke van de drie zou bij jullie het lastigst te beantwoorden zijn? Ik ben benieuwd.
Tot de volgende,
Jaap